监控调用与排查请求
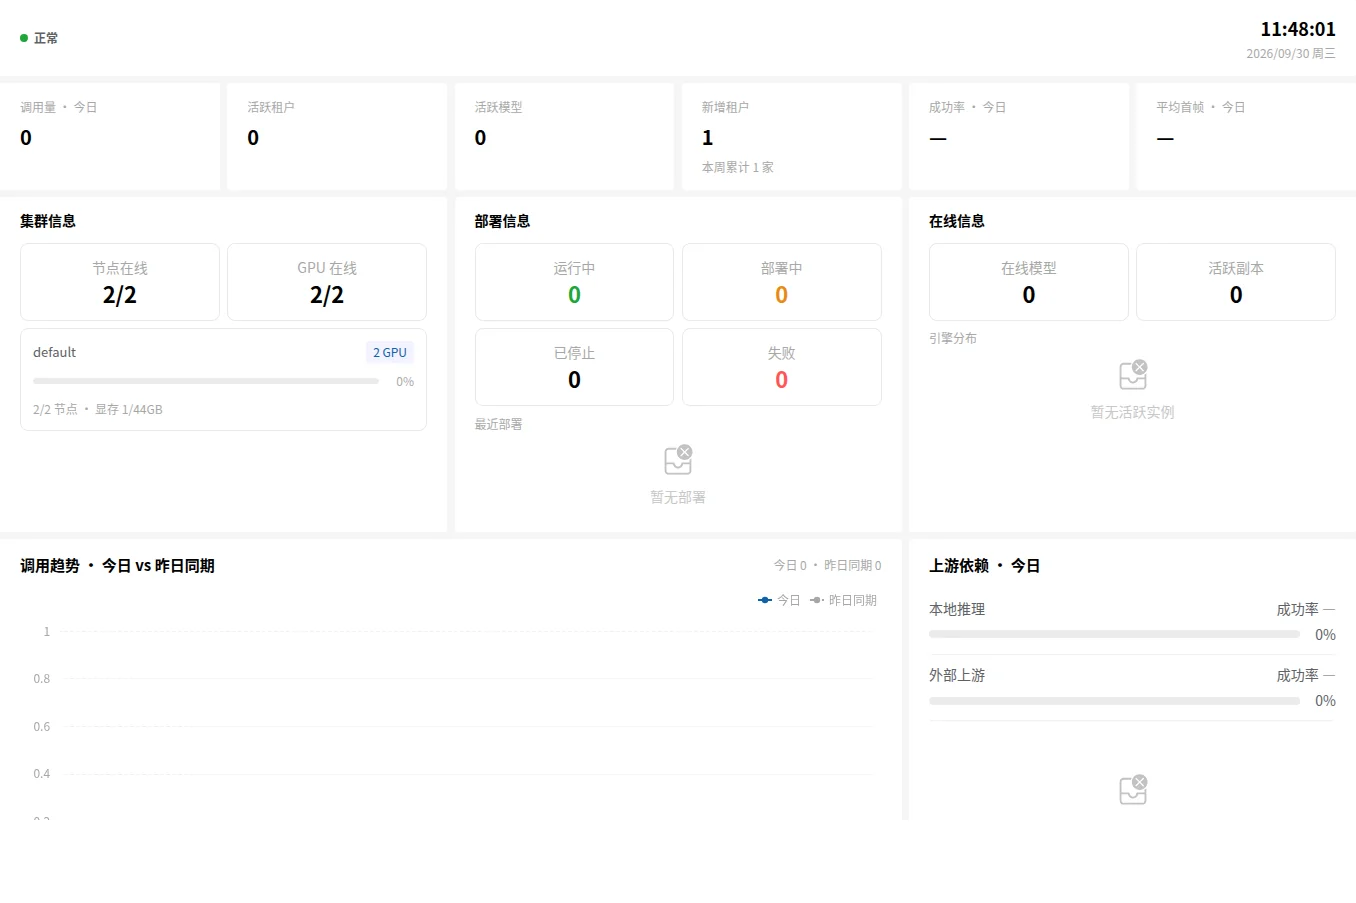
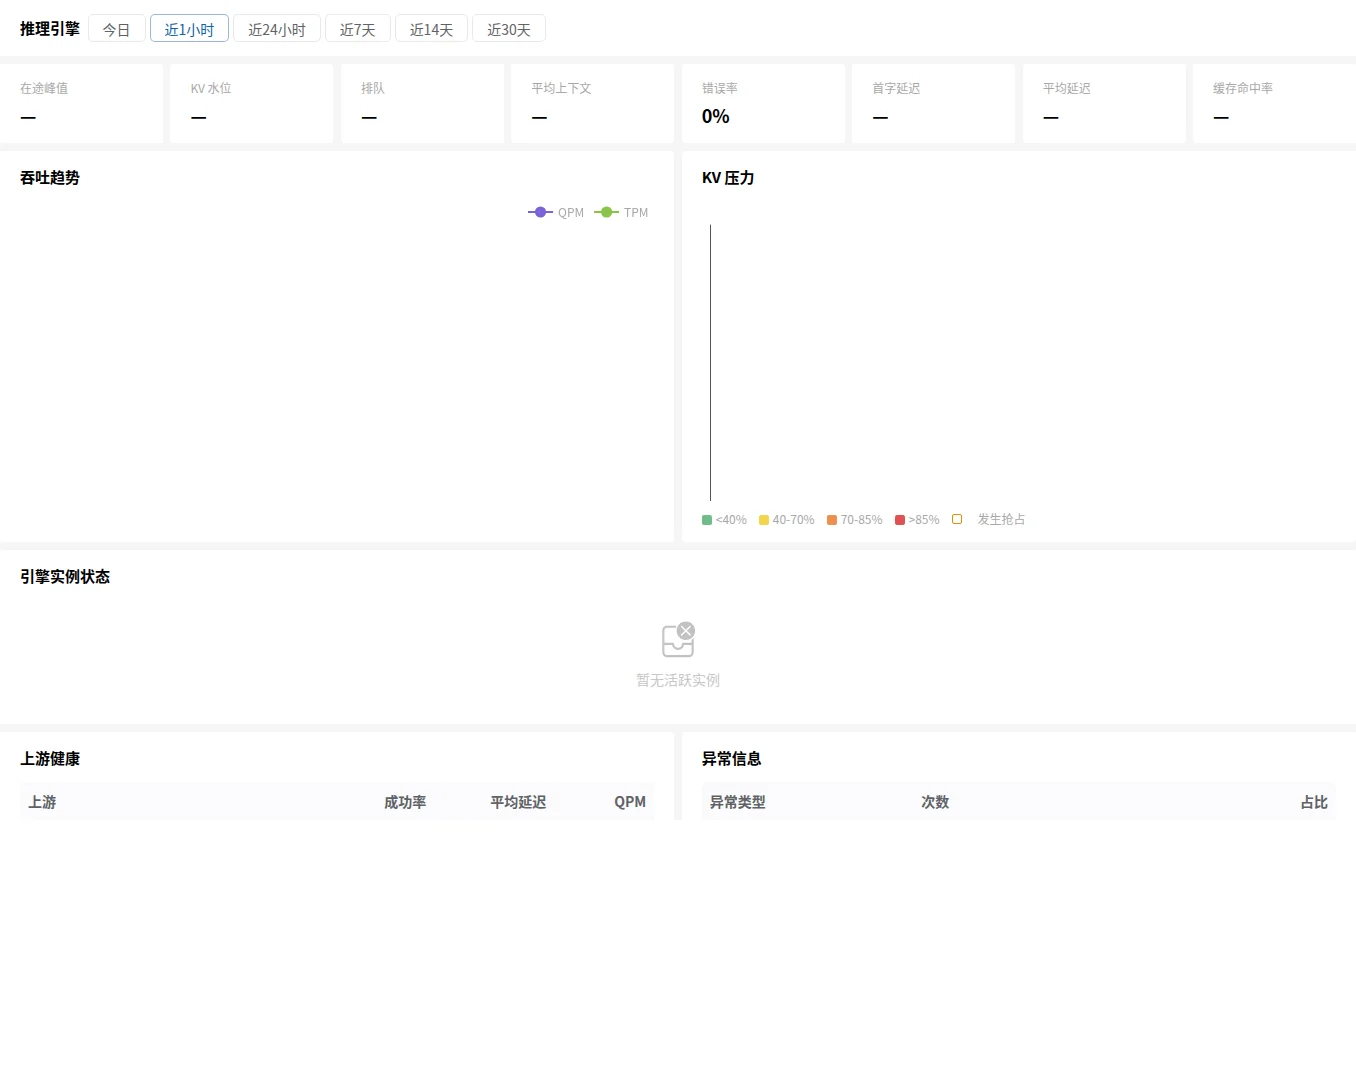
LLMPod 将平台整体状态、推理引擎指标、逐次请求和审计操作分开展示。先用控制台确定影响范围,再进入对应请求或服务日志。
| 你要了解 | 管理员入口 | 租户入口 |
|---|---|---|
| 集群、部署和上游整体状态 | 总览大屏 | 控制台中的本租户概览 |
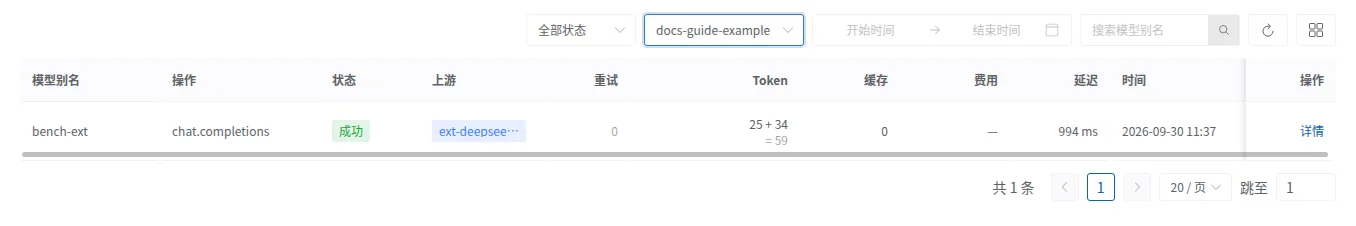
| 调用量、成功率、延迟趋势 | 仪表盘 → 调用统计 | 数据与费用 → 调用统计 |
| 吞吐、KV 压力、实例与上游健康 | 仪表盘 → 推理引擎 | 无平台级视图 |
| 某次请求的 Token、费用、错误和重试 | 审计和计费 → 计量计费 | 调用统计 → 请求详情 |
| 管理操作记录 | 审计和计费 → 审计日志 | 管理 → 审计日志(仅本租户) |
沿一条失败请求排查
- 记录调用时间、对外模型名和请求 ID。在调用统计中按时间、状态、模型或 Key 缩小范围。
- 若有请求记录,打开详情,判断是选路失败(没有可用绑定端点)还是上游调用失败(连接、超时或上游响应)。Key、权限和用量限制等准入拒绝不会写调用日志;此时依据 HTTP 状态码和网关日志排查。
- 对照路由所绑定的端点及部署状态:本地模型看部署详情的阶段和容器日志;外部端点看地址、上游 Key 与连接情况。
- 再查看数据面和控制面日志。官方安装脚本部署的实例可从安装目录执行(默认
/opt/llmpod):
cd /opt/llmpod
docker compose --env-file .env logs --tail=200 proxyserver webserver
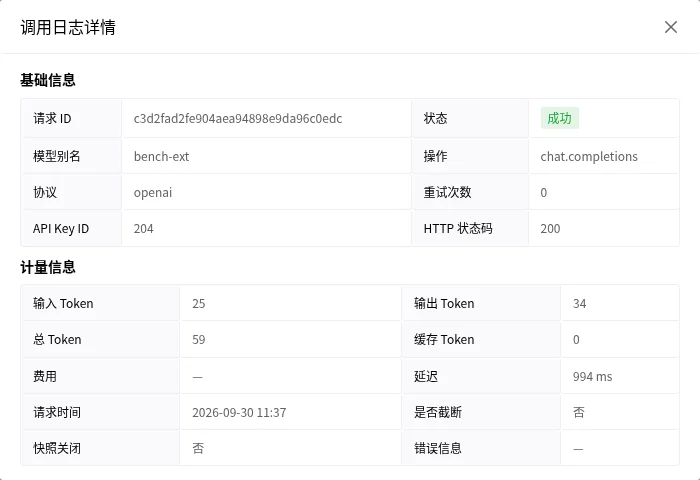
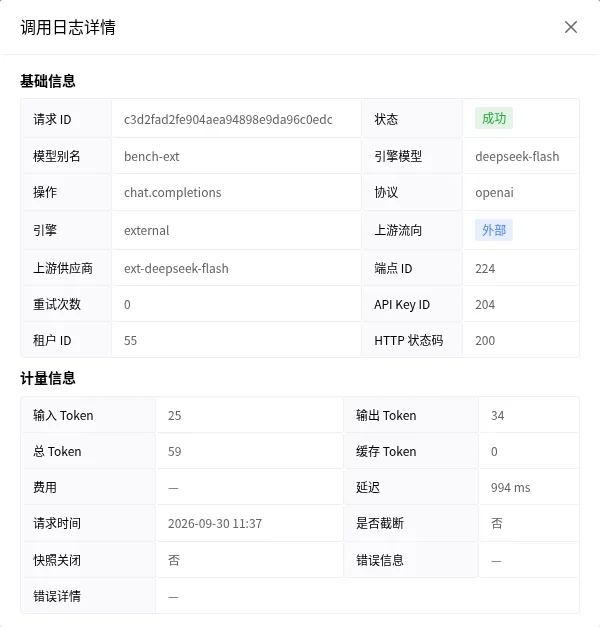
管理员“计量计费”当前主要是调用日志与费用明细;租户“费用中心”展示余额和流水。两者与管理员的审计日志用途不同。对外共享日志前,应移除 Key、密码和请求体中的敏感数据。
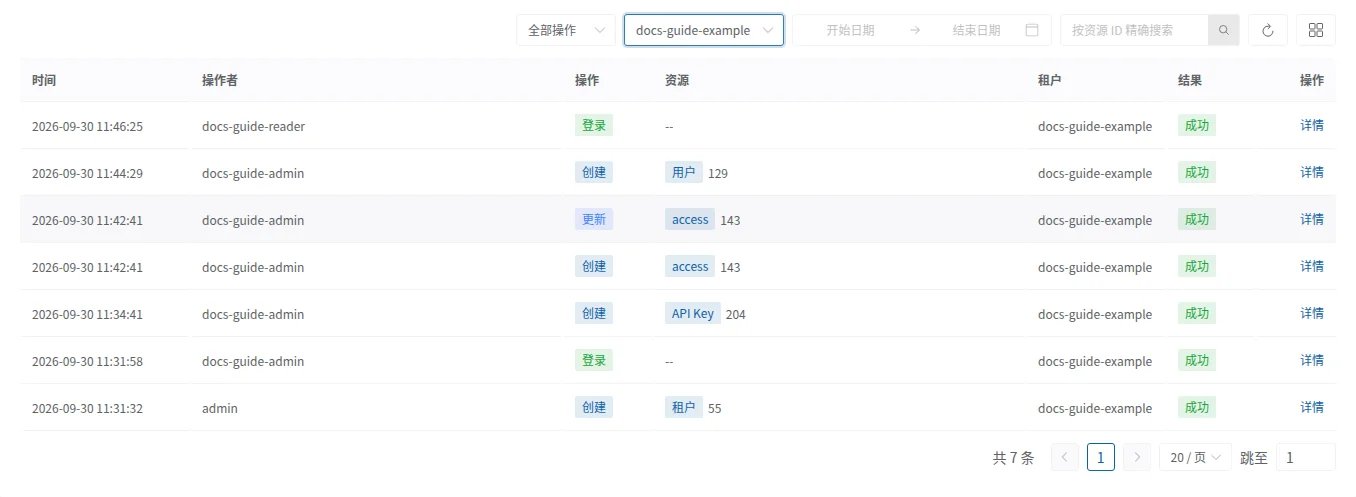
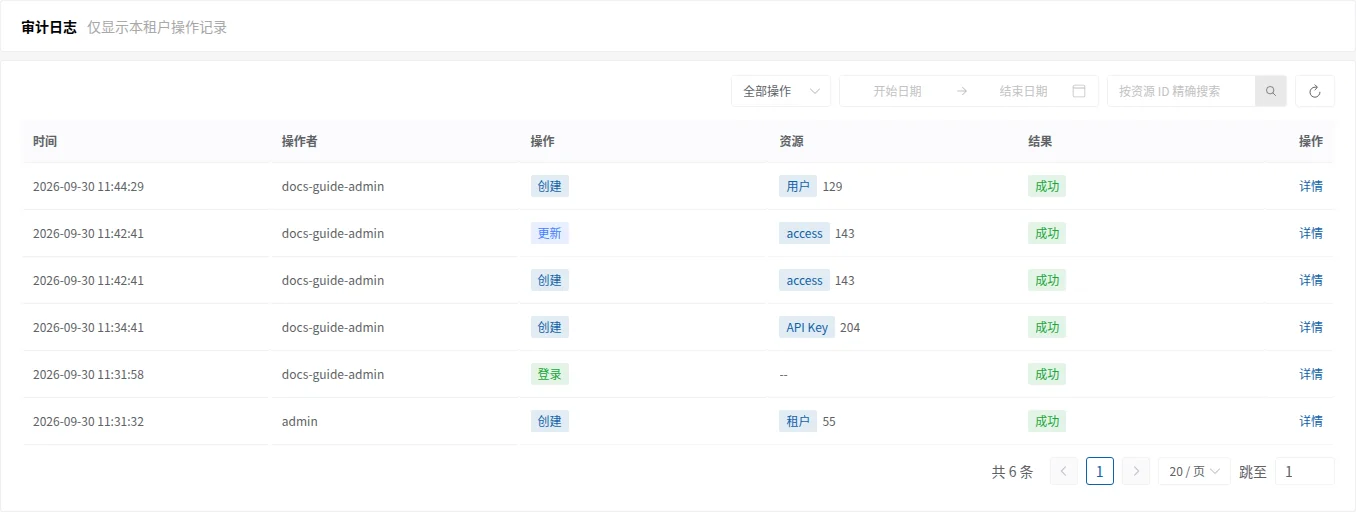
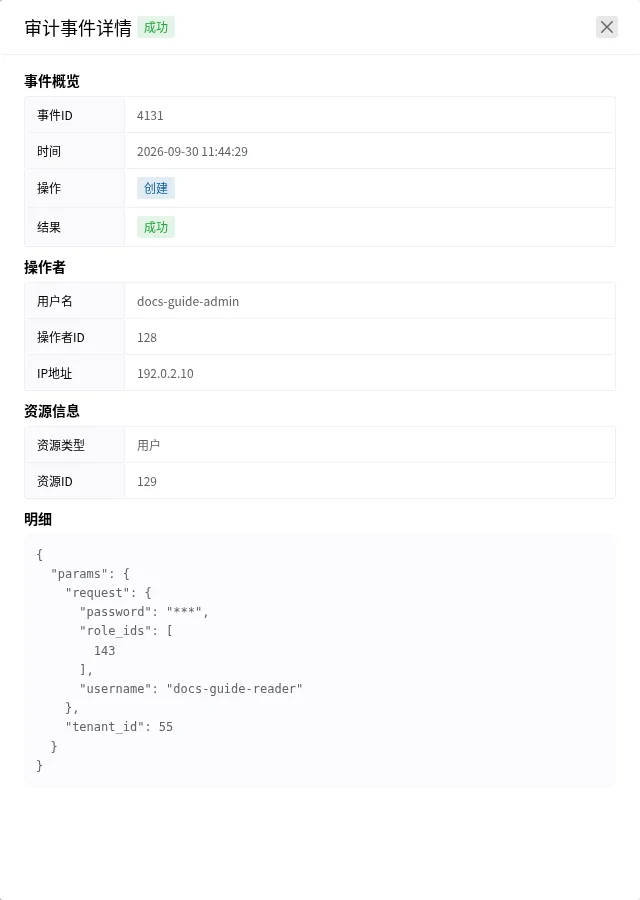
Anthropic Token Count 不产生账单或调用日志;当前 Embeddings 适配器也不写调用日志。不要把这些请求的日志缺席直接判断为网关未收到请求。
指标没有更新时
安装脚本生成的 Compose 配置中,webserver 通过内部网络抓取 proxyserver 的指标端点。先确认两个容器健康,然后检查推理网关的 /health,再看服务日志中的抓取错误。若使用自定义分容器部署,需要按实际网络配置指标抓取地址;不要把 Compose 内部服务名直接用于外部网络。